QwenImage 2.1 Heretic使用文档
# 一、模型部署
https://appstore.lazycat.cloud/#/shop/detail/cloud.lazycat.aipod.qwen-image-21-heretic
通过上面连接安装应用
安装完成之后打开该应用,显示界面如下,点击 "继续安装" 按钮会自动跳转到 AI Pod 部署。

选择要部署的算力舱

上面提到的部署参数也可以进行选择,一般是推荐默认配置 `W4A8`,如果用户有其他精度需求,则可以自行切换
**模型权重说明**
- **BF16**:原始训练精度,语义与图文对齐能力最完整、无损,但显存占用最大、推理速度受限于硬件原生支持度,仅适合显存充足的科研评测或高精度生产环境。
- **W4A8**:权重4-bit+激活8-bit混合量化,显存降至BF16的30%-40%且保留激活动态范围以避免多模态对齐崩塌,兼顾性能与精度,但需TensorRT-LLM/vLLM等特定框架支持,适合高并发服务端部署。
- **NVFP4**:NVIDIA Blackwell架构专属4-bit浮点格式,硬件原生加速下数值稳定性与速度优于传统INT4,但在旧卡上无加速甚至回退模拟计算变慢,仅适配新一代数据中心GPU。
- **GGUF**:消费级/边缘端通用格式,支持纯CPU、Apple Silicon及混合卸载,社区适配快、部署门槛低,但视觉编码器与投影层量化敏感,低量化版本易出现图文对齐失效,仅推荐Q5_K_M以上精度用于多模态任务。
下载源也可以切换,目前支持 `ModelScope` 和 `Hugging Face` 两个仓库源。建议国内用户优先选择 `ModelScope` 进行模型的下载
# 二、使用模型生成图片
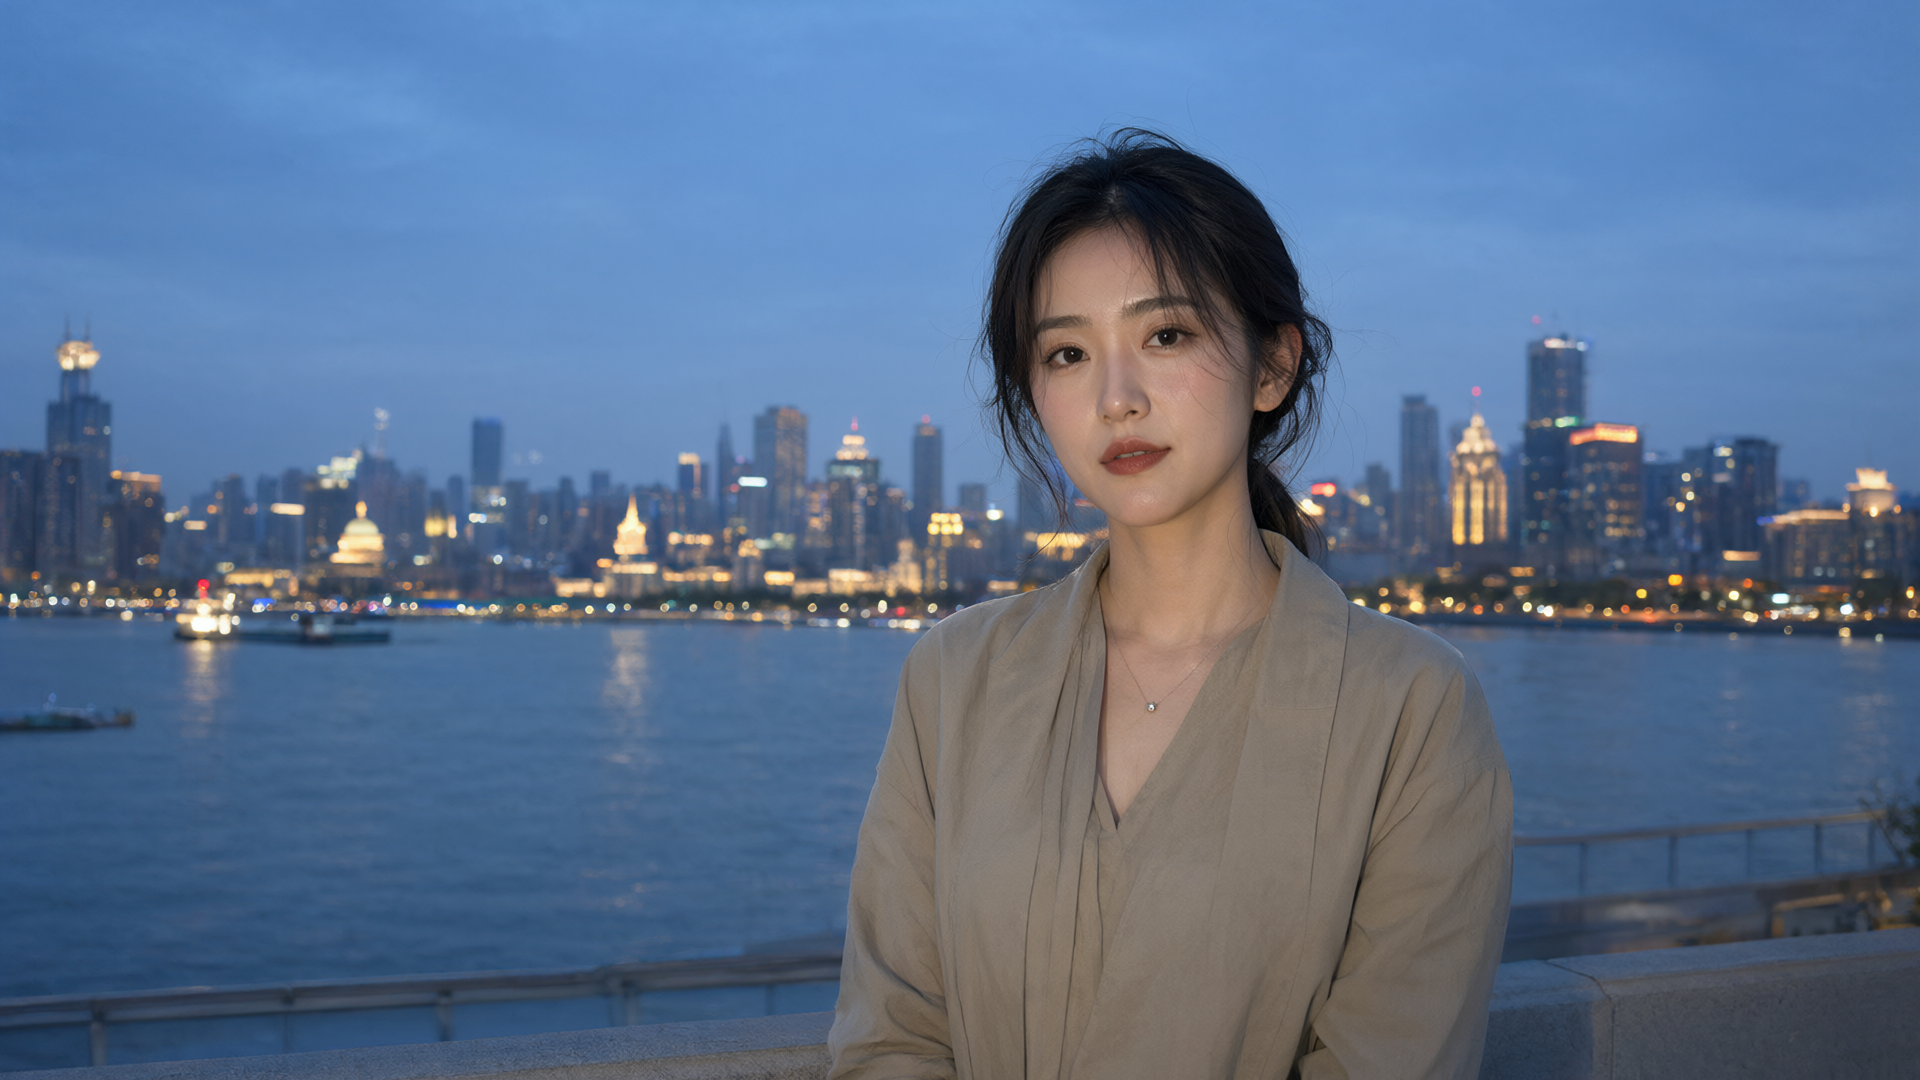
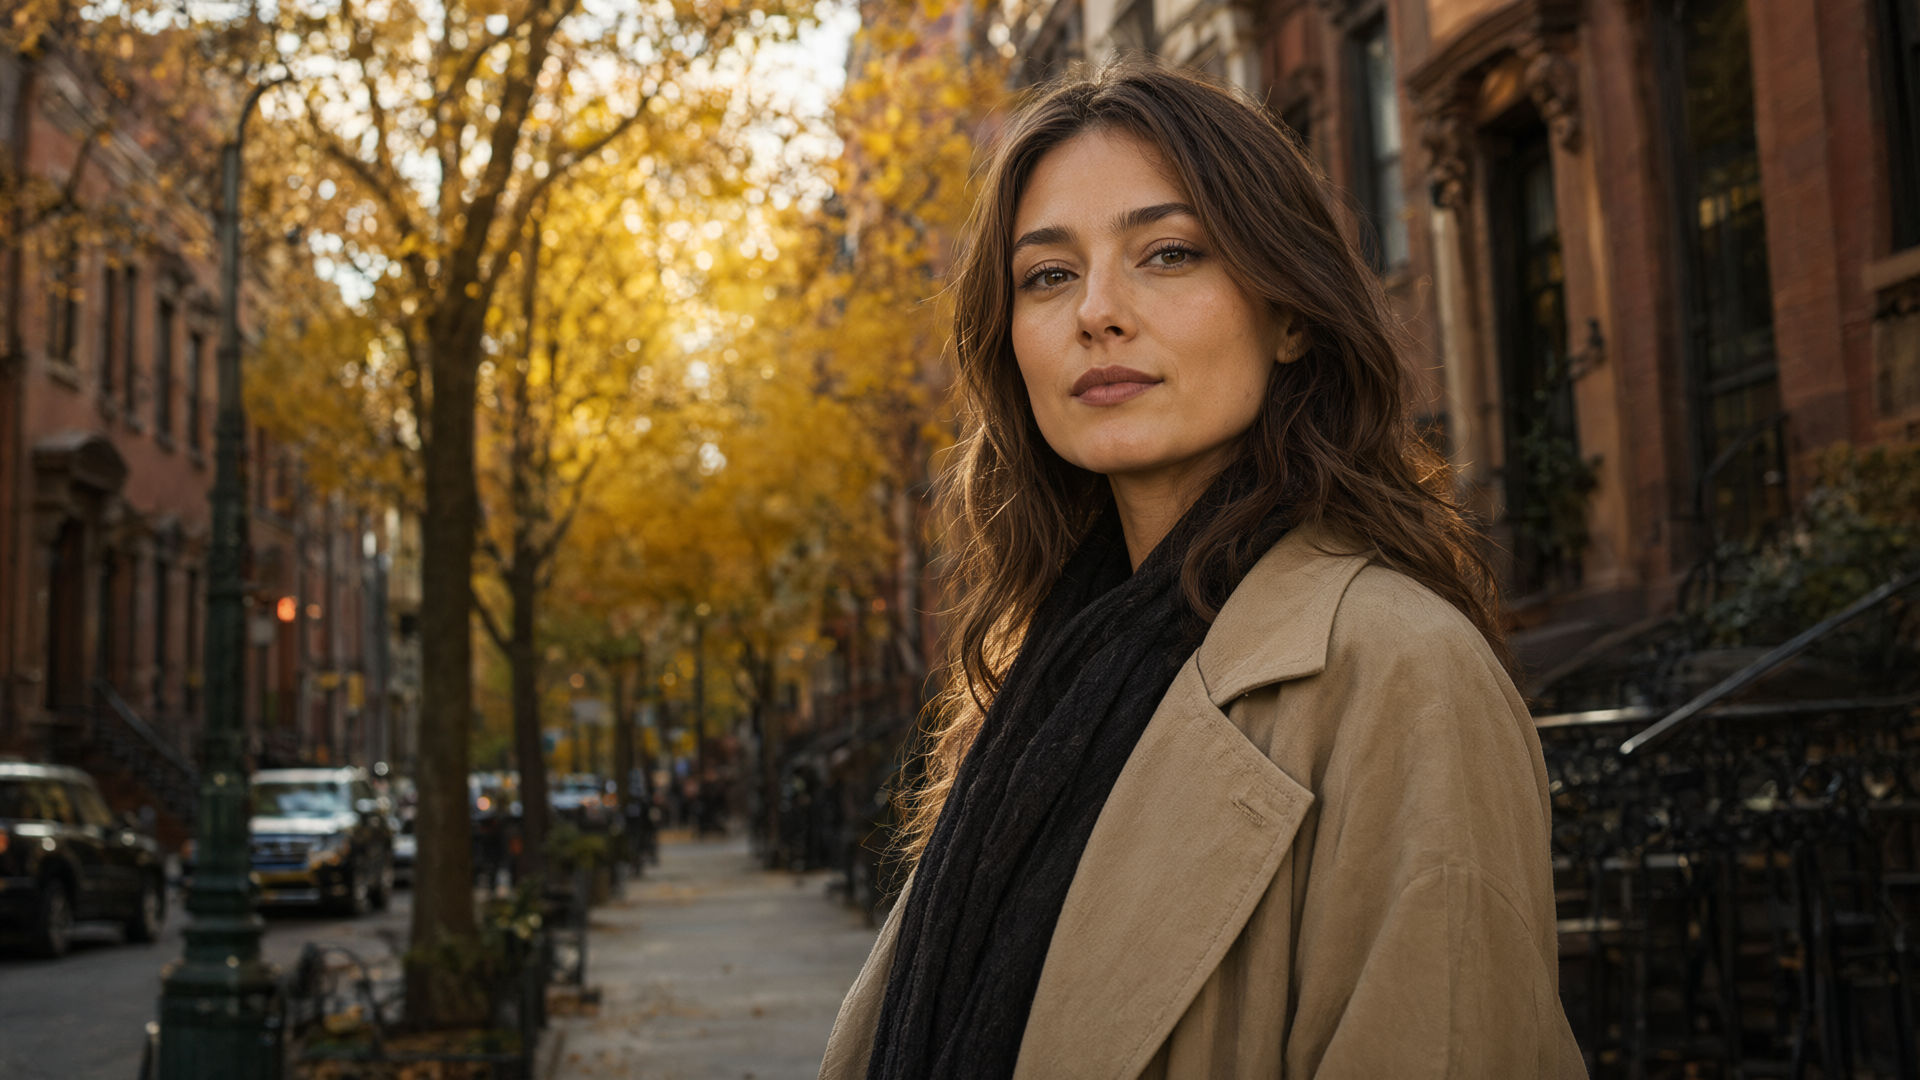
在局域网内,其他设备浏览器输入 `http://算力舱IP:8188` 就可以打开一个 ComfyUI 的网页,它会有一个默认的工作流,直接运行,生成的结果如下

如果想生成其他图片,在下图圈出的编辑区,输入新提示词,之后再点击右上角运行,等待生成即可。

**补充**:对于下图框选区域,这个编辑区是:决定你在生成图片的时候,剔除一些不需要的元素、风格等等一些其他因素。其他配置建议保持默认即可。
对于喜欢动手的大佬,也可以选择不使用默认模板配置,而是自己搭建适合自己的工作流。

# 三、扩展
https://appstore.lazycat.cloud/#/shop/detail/cloud.lazycat.app.forward
使用上面连接安装端口转发工具,参考下图配置
1. 出口地址:使用微服域名,并定义一个监听端口
2. 目标配置:算力舱ip和模型监听的端口
访问的时候使用 `微服名.heiyu.space:配置规则中出口定义的端口`

效果图展示

# Tips
**该模型使用特点**
- qwen image 2.1 heretic 的这个comfyui是专门为这个模型文件单独构建的,您要使用其他的工作流,建议您切换 comfyui 应用来使用






此 App 尚未收到足够的评分或评论,无法显示评论列表。