


GLM 5.3 Full
原始 Full 权重,双 Thor 并行推理与 DFlash2 辅助解码

安装次数
点赞
应用评论
催更次数
桌面端

应用描述
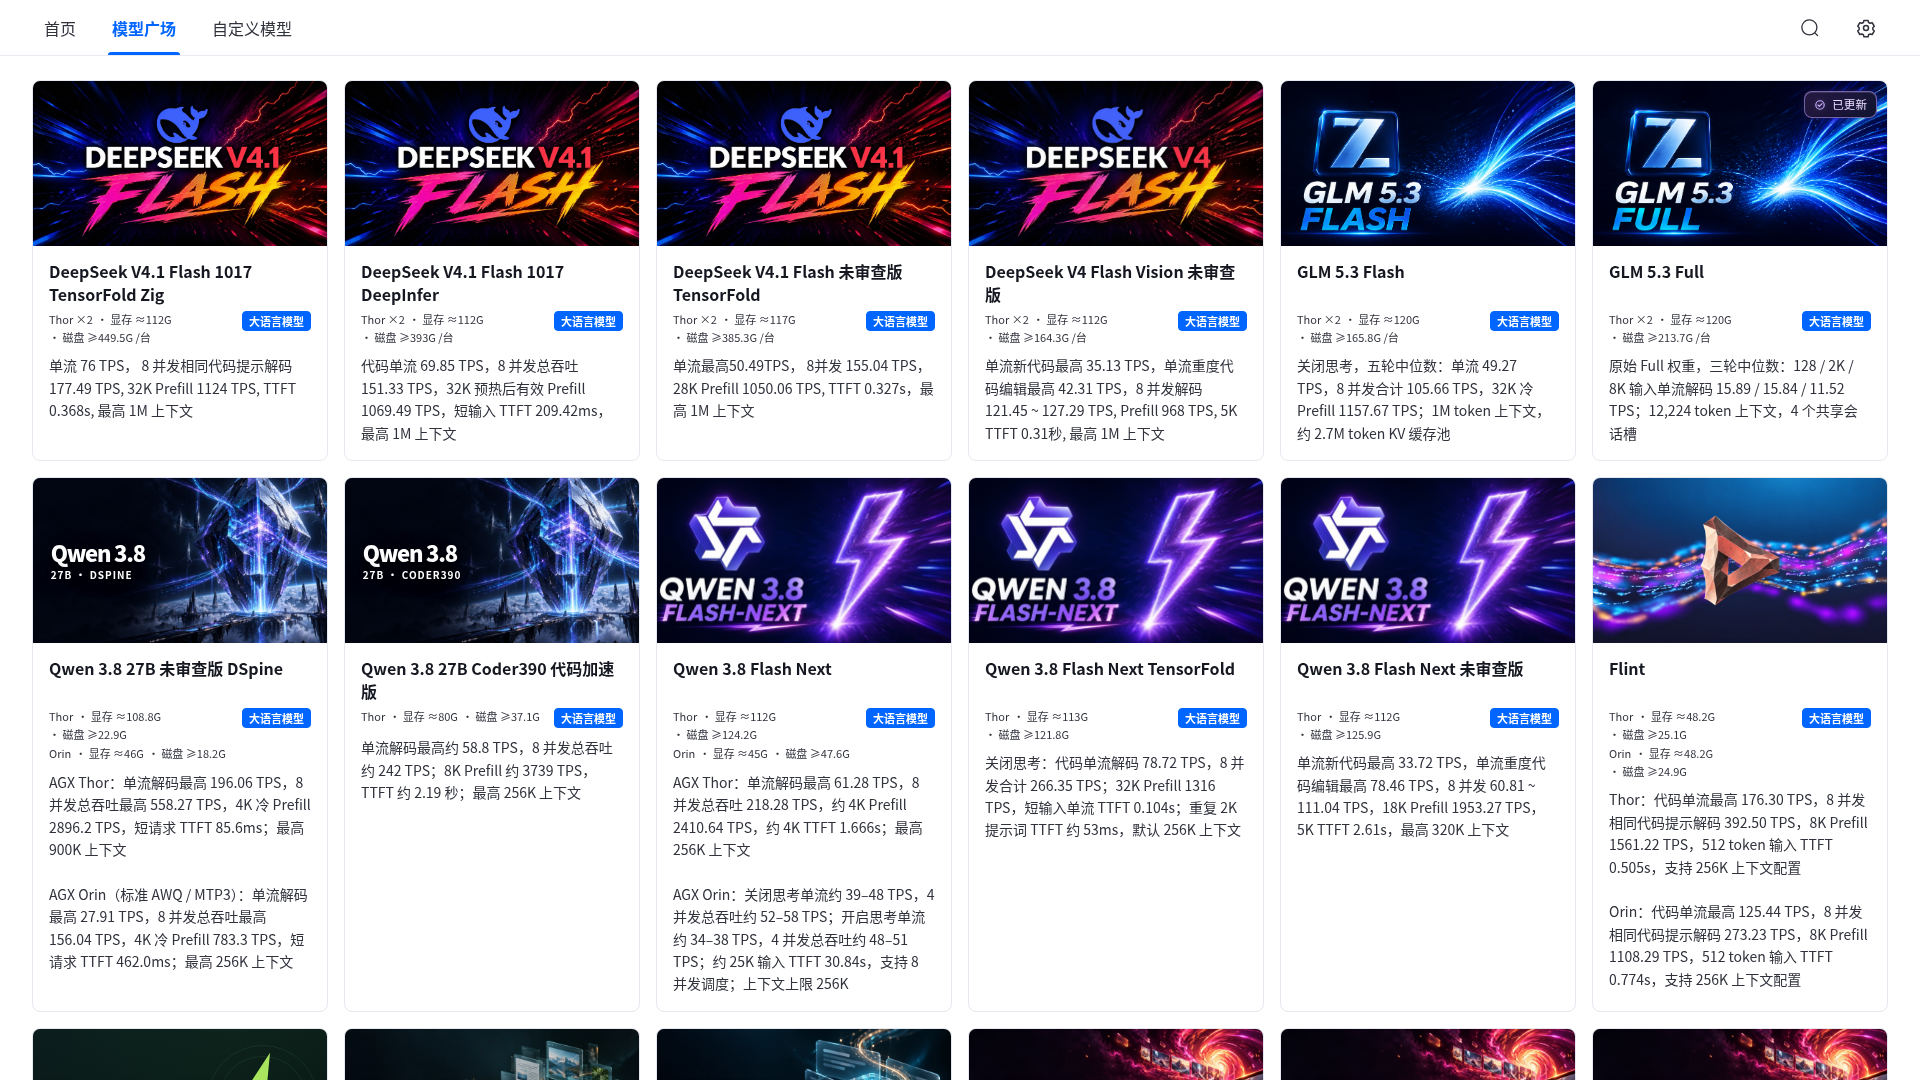
GLM 5.3 Full 模型部署插件,配合 AI Pod 使用。主模型与 kindlingai/glm-5.3-exlr8-k2-k3-k4 的原始 Full 权重一致。 需要两台 Jetson AGX Thor,采用 TP2、四路光口与 DFlash2 辅助解码。支持 12,224 token 请求上限和四个共享会话槽,提供原生累计用量统计。模型及运行归档提供固定版本的 Hugging Face / ModelScope 双源。 安装后从入口进入 AI Pod 模型广场完成设备选择和部署。每台设备建议预留至少 213.7 GiB 模型存储空间,并留出运行缓存空间。 最终 LPK 在 192.168.1.160 和 192.168.1.134 两台 Jetson AGX Thor 上实测:128 / 2K / 8K 输入、单流输出 256 token,三次中位数为 15.92 / 15.80 / 11.38 TPS。30 TPS 目标尚未达到,实际速度随设备、输入和运行状态变化。 本插件不是 GLM 5.3 Flash。主模型来源:https://huggingface.co/kindlingai/glm-5.3-exlr8-k2-k3-k4
懒猫评分/评论
0.0
0 条评论
应用信息

新功能
版本历史记录
GLM 5.3 Full:原始 EXLR8 Full 权重,双 Jetson AGX Thor、四路光口与 DFlash2 辅助解码。支持四并发和12224-token请求上限,提供原生累计用量统计。模型、运行归档和控制面提供固定版本的 Hugging Face / ModelScope 双源。128、2K、8K 单流30TPS目标尚未达到,性能结果见随包报告。
此 App 尚未收到足够的评分或评论,无法显示评论列表。